01//
Schatten-IT & Datenlecks
Mitarbeiter schicken sensible Firmendaten an unkontrollierte Large Language Models (LLM) in der Consumer-Cloud, und zwar ohne Freigabe, ohne Protokoll und ohne Löschkonzept.
// Branchen
Für Werke, Maschinenbauer, Finanzhäuser und Medizintechnik bleiben Small Language Models (SLM) und Retrieval-Augmented Generation (RAG) On-Premises und laufen mit Zero Data Retention.
Die Inferenz läuft im eigenen Rechenzentrum oder auf dem Edge-Knoten in der Halle, sodass statt Token-Gebühren Strom und Abschreibung anfallen und personenbezogene Daten das Firmennetz nicht verlassen.
On-Premise Enclaves
Datensouveräne KI-Infrastruktur
Multi-Agent Workflows
Autonome Prozess-Orchestrierung
Enterprise Knowledge
Sichere RAG- & Vektorsuche
Edge & Embedded AI
Latenzarme SLM-Integration
// Risiko
Drei Fehlerbilder aus Projekten mit Künstlicher Intelligenz (AI), an denen der Produktionsstart scheitert.
Mitarbeiter schicken sensible Firmendaten an unkontrollierte Large Language Models (LLM) in der Consumer-Cloud, und zwar ohne Freigabe, ohne Protokoll und ohne Löschkonzept.
Der Prototyp läuft im Demo-Tenant mit zehn Testnutzern, doch für den Betrieb fehlen Rechtekonzept und Lastprofil, weshalb der Übergang in die Produktion ausbleibt.
Starr angebundene SaaS-Modelle erzeugen unkalkulierbare API-Kosten, denn die Token-Rechnungen wachsen mit jeder Abteilung, während der Vertrag nicht mitwächst.
// Services
Künstliche Intelligenz (AI) für den DACH-Mittelstand umfasst Governance, Modellform, Retrieval-Augmented Generation (RAG) und Hardware, die im Haus bleibt.
 EU AI Act: Risikoklasse, Pflichten und Nachweis-Dokumentation
 LoRA und QLoRA (Low-Rank Adaptation) für Form, Stil und JSON-Syntax
 HyDE (Hypothetical Document Embeddings) und Reciprocal Rank Fusion
 Small Language Models (SLM) auf NVIDIA Jetson, Mac Studio und AI-PCs
// Architecture
Large Language Models (LLM) liefern Tokens, während LangGraph den Zustand zwischen Oberfläche, Vektordatenbank und Freigabe hält. Eine lineare Kette endet, ein zyklischer Graph dagegen korrigiert.
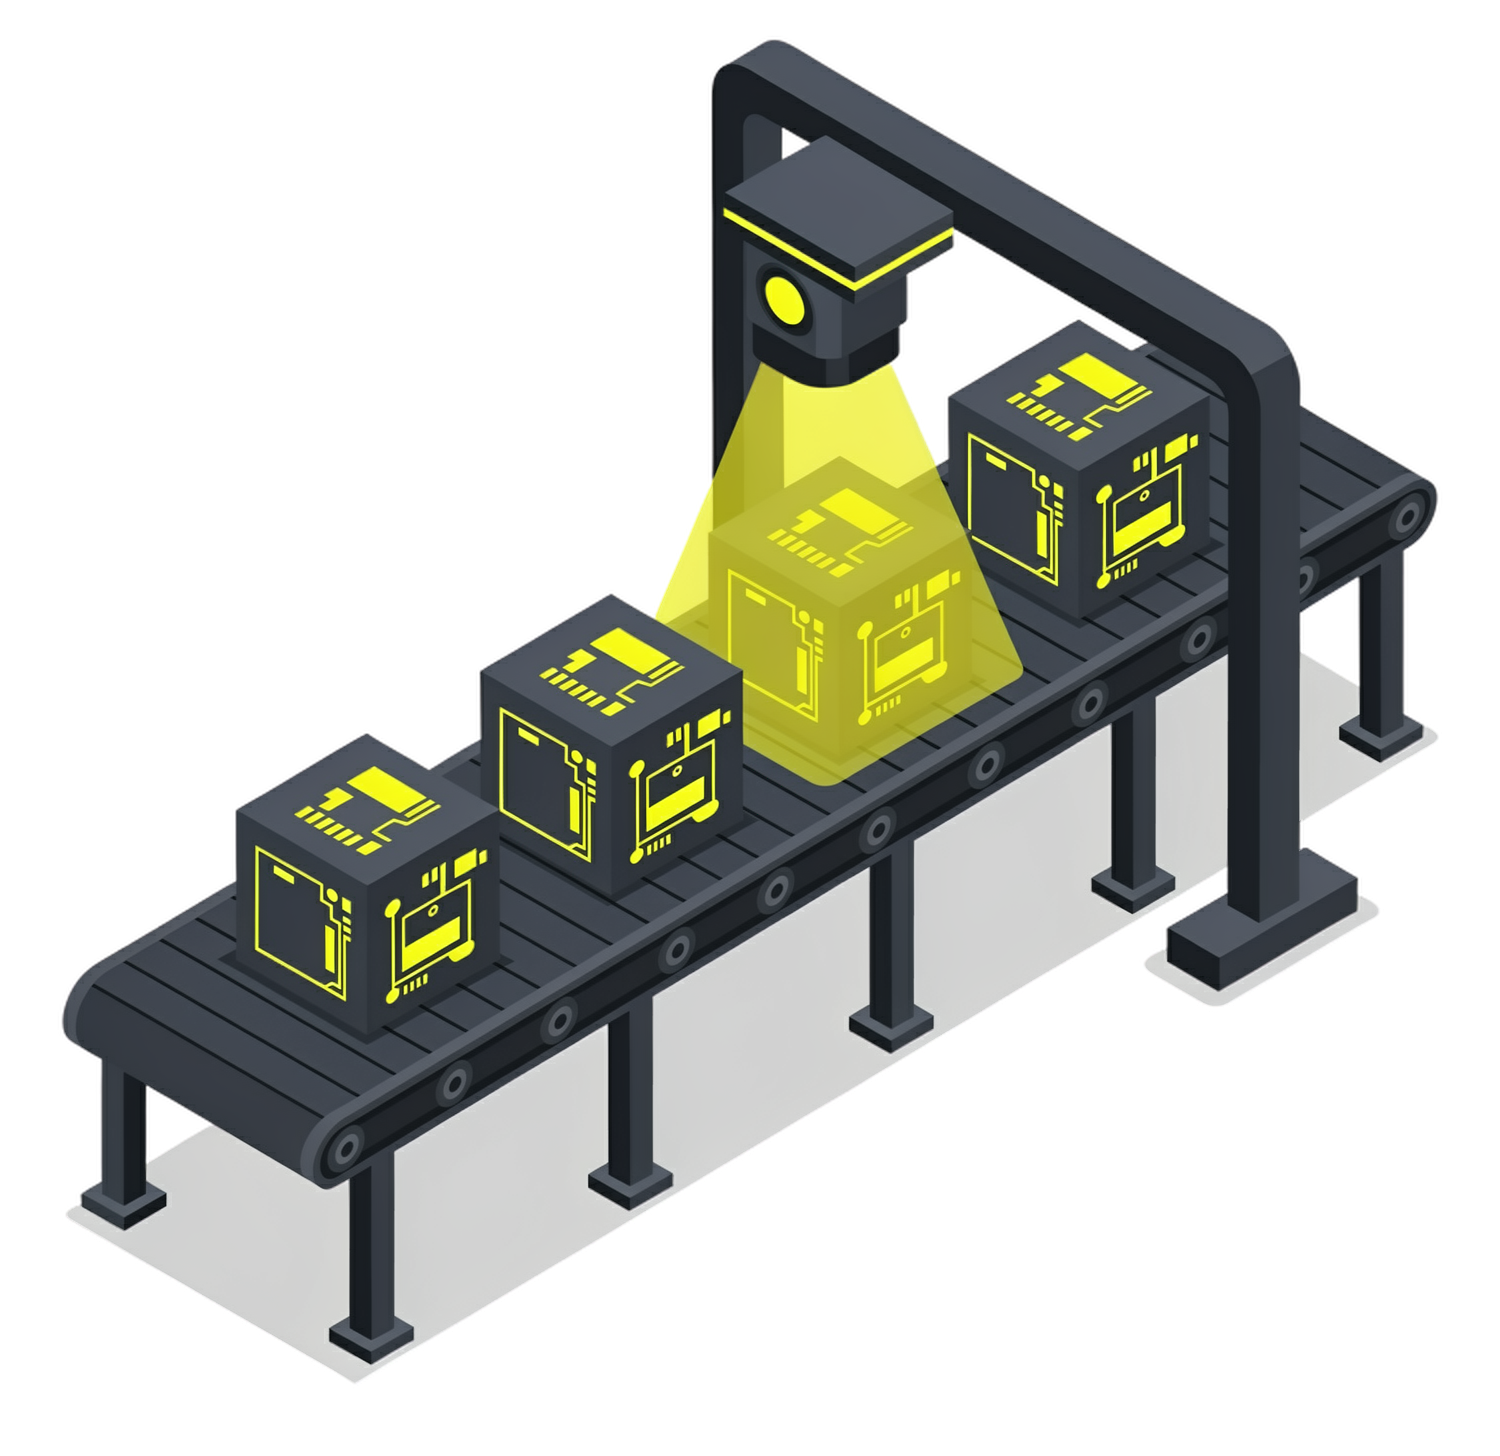
Der Pfad ist gerichtet und kennt keine Rückkehr, sodass ein Fehlversuch oder eine fehlende Quelle die Kette beendet.
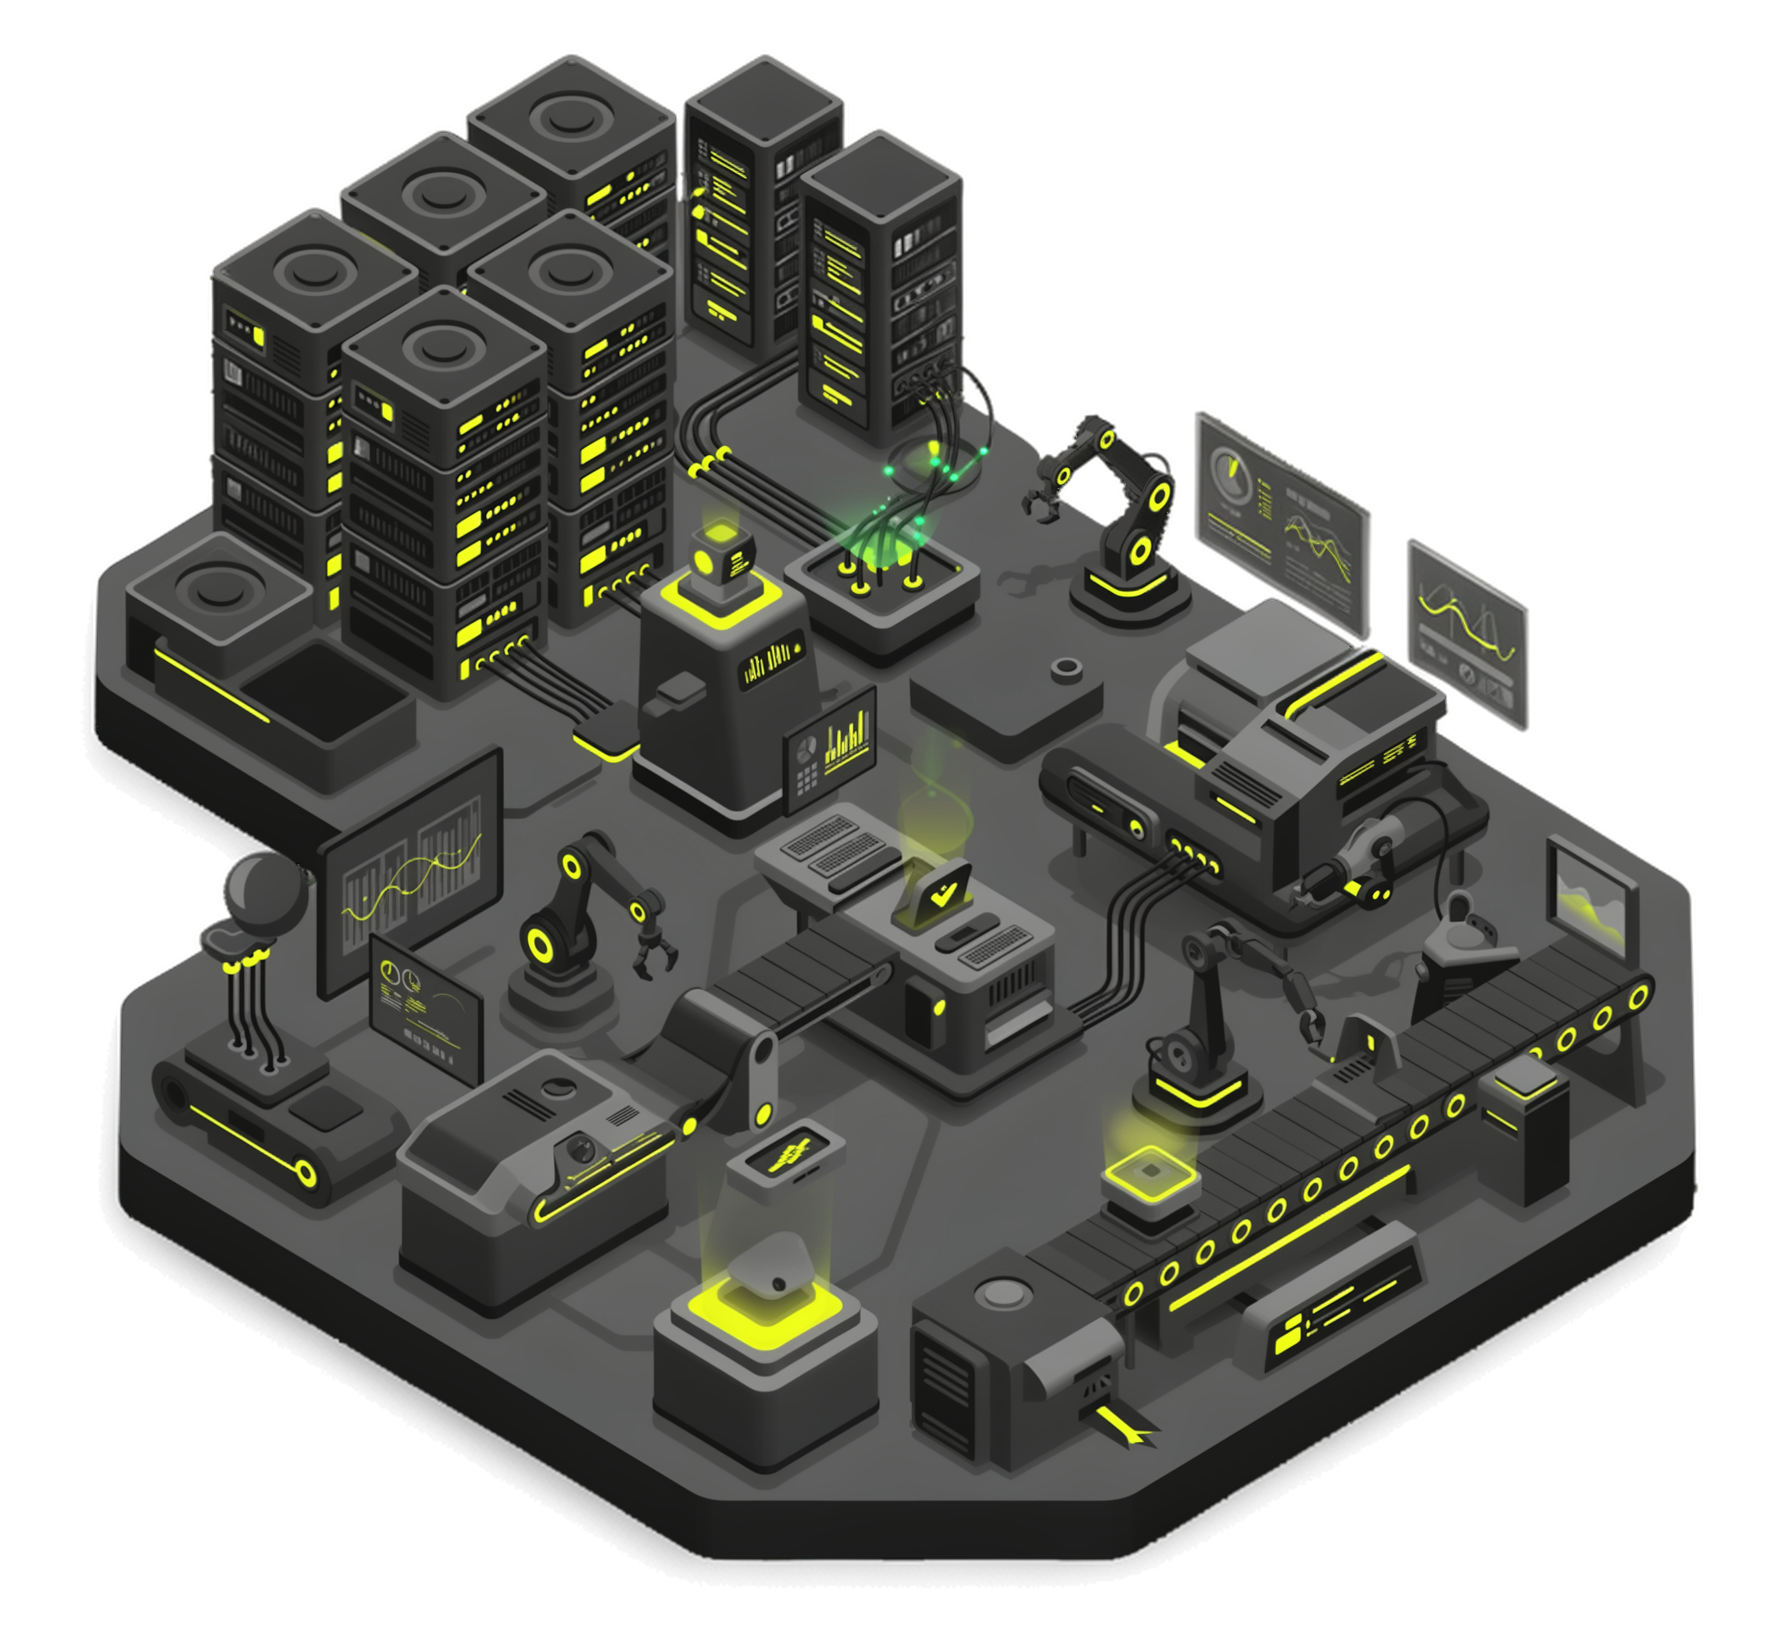
Der Check schickt den State zurück oder zur menschlichen Freigabe, während kritische Aktionen warten.
vLLM
Inferenz-Server
TensorRT-LLM
GPU-Serving
LangGraph
Zyklische Orchestrierung
Qdrant
Vektordatenbank
pgvector
PostgreSQL-Vektoren
NeMo Guardrails
Prompt-Grenzen
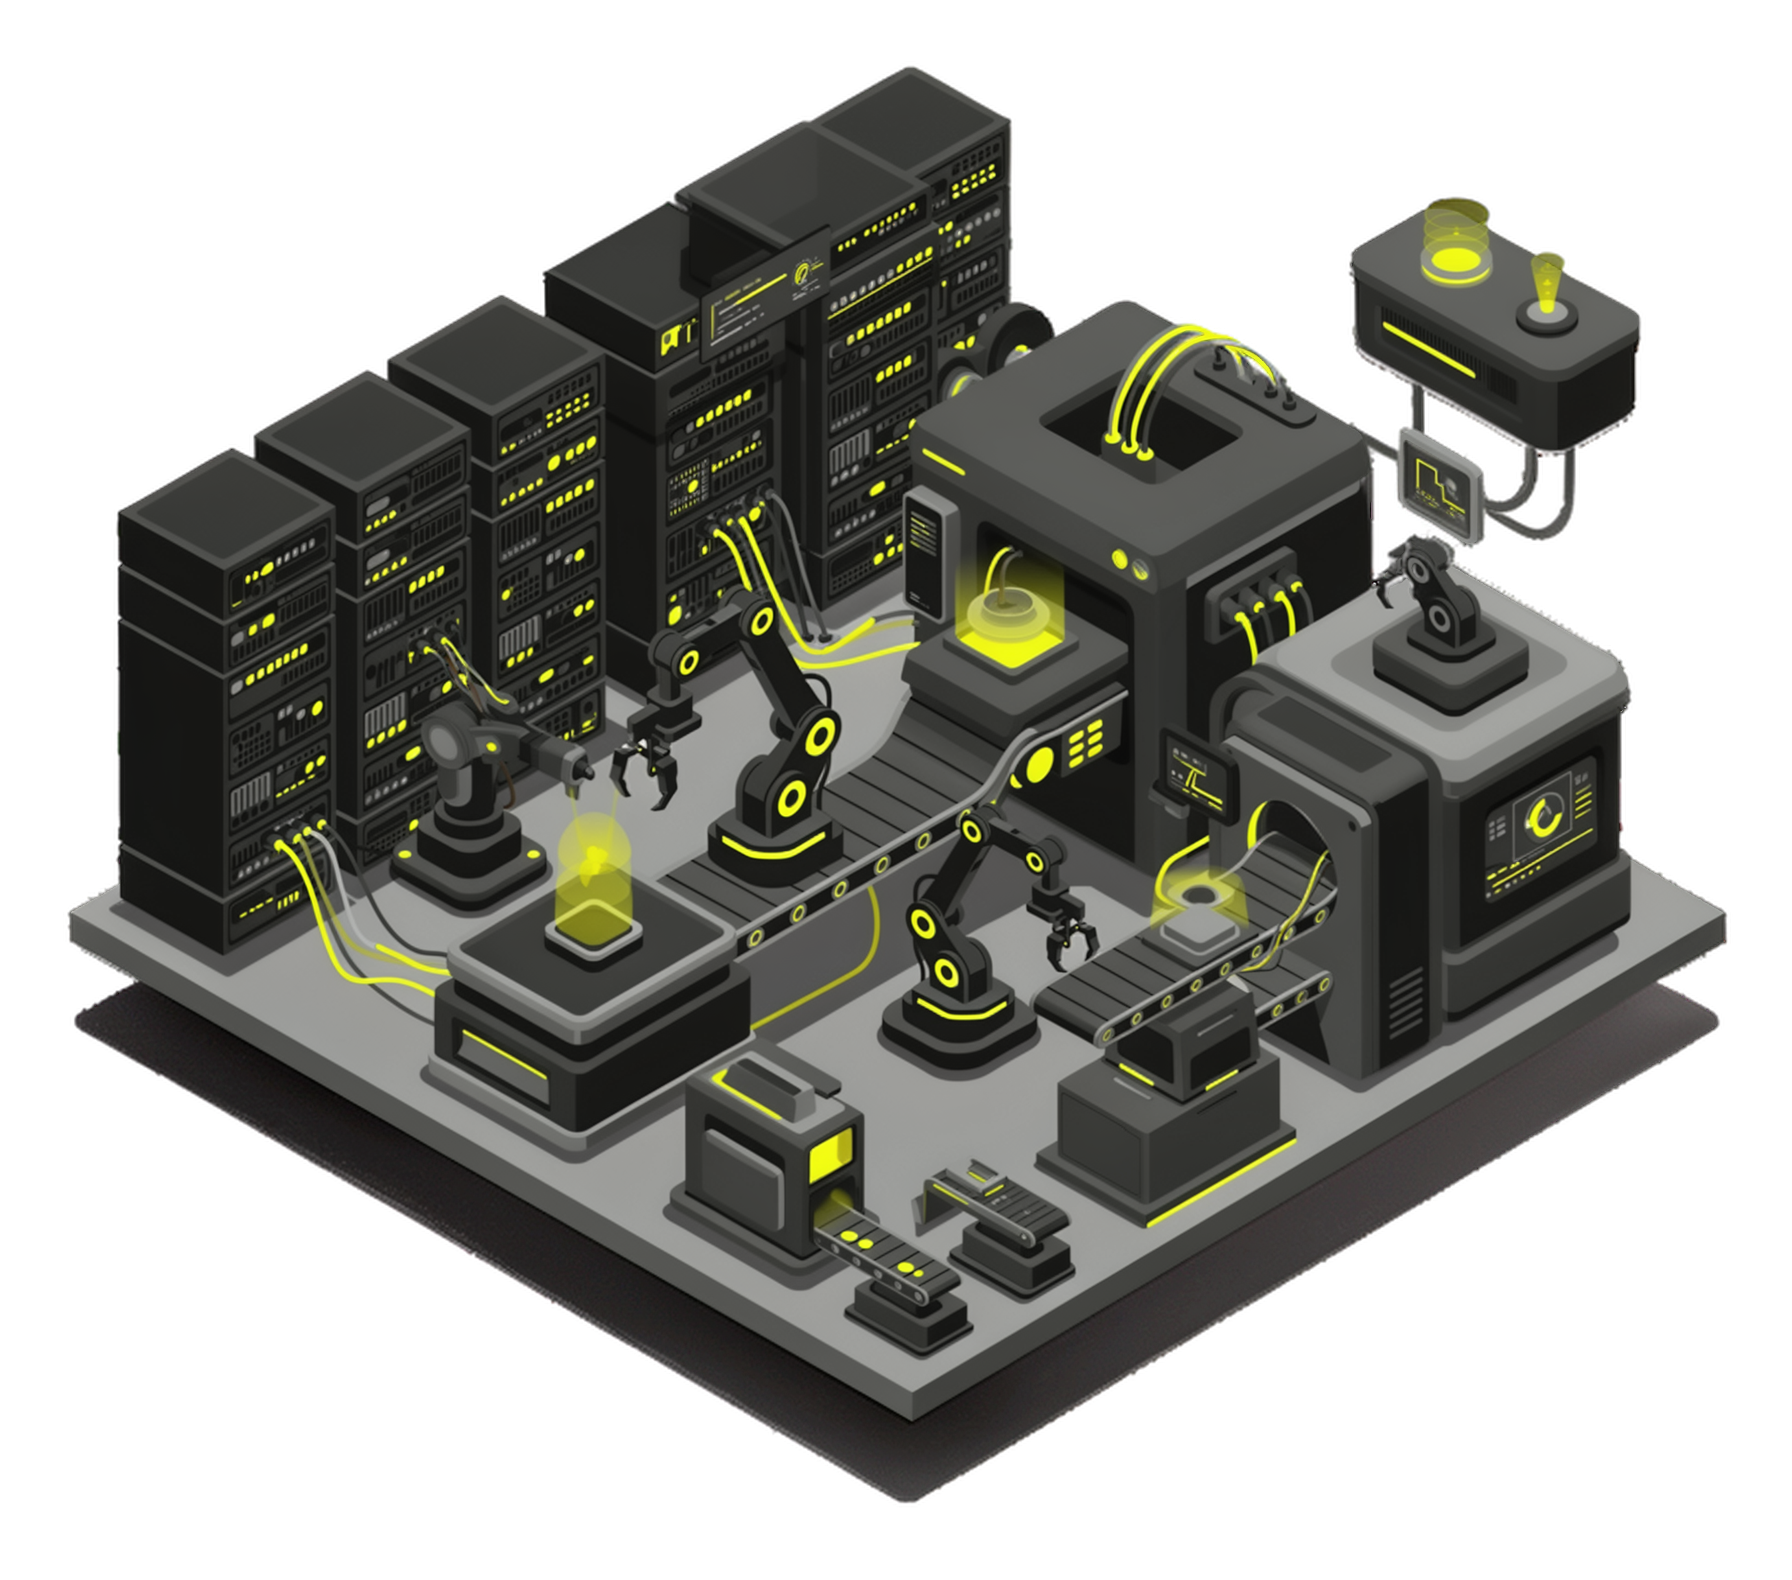
Die Pipeline besteht aus fünf Stationen: Datenquelle, Vektordatenbank, Agentenlogik, Modell und Guardrail. Wer links auswählt, sieht rechts den Aufbau.
FACTORY FLOOR VIEWGRID: ISOMETRIC 2.5D// Sprint
In vier Wochen führt der Sprint von der Risikoklasse zur Übergabe, damit Künstliche Intelligenz (AI) in den Betrieb geht und nicht in einen weiteren Prototyp.
// Audit
Ein Termin klärt Datenfluss und EU AI Act sowie die Frage, ob Large Language Models (LLM) On-Premises bleiben.
Kontakt // Schreiben Sie uns
Retrieval-Augmented Generation (RAG) durchsucht die eigenen Dokumente, und Small Language Models (SLM) formulieren die Antwort auf eigener Hardware, sodass kein Prompt an eine fremde API geht. Die Betriebskosten stehen schon vor dem Rollout fest.